JavaScript
面试题标题前 Emoji 含义
⭐ 表示重点问题。------------------------(必须熟练掌握)
✔️ 表示普通问题。---------------------- (内容不会轻易变动)
❓ 表示此问题还需完善。-----------------(后面会对内容进行完善)
❗ 表示此问题已经过时。-----------------(过时问题不会被剔除,一直存在)
ECMAScript
1、代码规范
变量:声明变量必须加上var关键字,而且每个var只声明一个变量,增加可读写。
常量:常量的命名方式:用大写字符,并用下划线分隔。
with(){}  尽量少用。
缩进  用4个空格作为一缩进,而不是使用tab
字符串过长截取   每行代码不超过80个字符。如代码过长,可使用+运算符拼接。
构造函数  对于构造函数,命名采用首字母大写,其他函数一律小写。
注释  合理的加上注释,有利于后期维护,提高可读性。
{}和[]   使用{}代替new Object(),使用[]代替new Array()
单引号(') 尽量使用单引号('),只在JSON文件中使用双引号。
变量和函数声明  变量名和函数名在JavaScript机制下会发生声明提升(也就是会提前到顶部声明),所以建议变量和函数应该在使用前声明。
使用===和!==代替==和!=  在JavaScript中,比较运算符进行计算时会进行强制转换,==和!=会产生一些意想不到的结果,所以应该用“严格相等”===
换行  在语句块和下一个语句之间留一个空行,提高可读性。
命名  构造函数或类名使用驼峰式命名
语句  对于复合语句,if, for, while, do, switch, try … catch 等代码体,函数定义的函数体,对象的定义等都需要放在花括号'{}'里面。
for-in  对于数组,尽量避免使用for-in
⭐ 2、JS 数据类型(有哪些?区别?如何判断?)
基本数据类型:Number、String、Boolean、Null、Undefined、symbol、bigint
引用数据类型:Object、Array、Function
基本数据类型的特点:直接存储在栈中的数据
复杂数据类型的特点:存储的是该对象在栈中引用,真实的数据存放在堆内存里
undefinde 和 null 的区别?
undefinde:声明未赋值,或者是对象里的一个属性未定义
null:声明了也赋值了,赋的值就是个null,因为null它是一个空,不占用空间
undefined 表示变量声明但未初始化时的值
null 表示准备用来保存对象,还没有真正保存对象的值。从逻辑角度看,null 值表示一个空对象指针
ECMA 标准要求 null 和 undefined 等值判断返回 true null == undefined // true null === undefined // false
如何判断 JS 的数据类型?
**判断方法** typeof

typeof 可以用来区分除了 null 类型以外的原始数据类型,对象类型的可以从普通对象里面识别出函数:

typeof undefined // "undefined" typeof null // "object"

typeof 1 // "number"

typeof "1" // "string" typeof Symbol() // "symbol"

typeof function() {} // "function" typeof {} // "object"

问题一:typeof 不能识别 null,如何识别 null?

答案:如果想要判断是否为 null,可以直接使用===全等运算符来判断(或者使用下面的 Object.prototype.toString 方法):

let a = null

a === null // true

问题二:typeof 作用于未定义的变量,会报错吗?答案:不会报错,返回"undefined"。

typeof randomVariable // "undefined"问题三:typeof Number(1)的返回值是什么?

答案:"number"。注意 Number 和 String 作为普通函数调用的时候,是把参数转化为相 应的原始数据类型,也就是类似于做一个强制类型转换的操作,而不是默认当做构造函数

调用。注意和 Array 区分,Array(...)等价于 new Array(...) typeof Number(1) // "number"

typeof String("1") // "string" Array(1, 2, 3)

// 等价于

new Array(1, 2, 3)

问题四:typeof new Number(1)的返回值是什么?

答案:"object"。

typeof new Number(1) // "object" typeof new String(1) // "object" instanceof

instanceof 不能用于判断原始数据类型的数据:

3 instanceof Number // false '3' instanceof String // false true instanceof Boolean // false

instanceof 可以用来判断对象的类型: var date = new Date()

date instanceof Date // true var number = new Number()

number instanceof Number // true var string = new String()

string instanceof String // true

需要注意的是,instanceof 的结果并不一定是可靠的,因为在 ECMAScript7 规范中可以通过自定义 Symbol.hasInstance 方法来覆盖默认行为。

Object.prototype.toString Object.prototype.toString.call(undefined).slice(8, -1) // "Undefined" Object.prototype.toString.call(null).slice(8, -1) // "Null" Object.prototype.toString.call(3).slice(8, -1) // "Number" Object.prototype.toString.call(new Number(3)).slice(8, -1) // "Number" Object.prototype.toString.call(true).slice(8, -1) // "Boolean" Object.prototype.toString.call('3').slice(8, -1) // "String" Object.prototype.toString.call(Symbol()).slice(8, -1) // "Symbol"

由上面的示例可知,该方法没有办法区分数字类型和数字对象类型,同理还有字符串类型和字符串对象类型、布尔类型和布尔对象类型

另外,ECMAScript7 规范定义了符号 Symbol.toStringTag,你可以通过这个符号自定义 Object.prototype.toString 方法的行为:

'use strict'

var number = new Number(3) number[Symbol.toStringTag] = 'Custom'

Object.prototype.toString.call(number).slice(8, -1) // "Custom" function a () {}

a[Symbol.toStringTag] = 'Custom' Object.prototype.toString.call(a).slice(8, -1) // "Custom" var array = []

array[Symbol.toStringTag] = 'Custom' Object.prototype.toString.call(array).slice(8, -1) // "Custom"

因为 Object.prototype.toString 方法可以通过 Symbol.toStringTag 属性来覆盖默认行为,所以使用这个方法来判断数据类型也不一定是可靠的

Array.isArray

Array.isArray(value)可以用来判断 value 是否是数组: Array.isArray([]) // true

Array.isArray({}) // false

(function () {console.log(Array.isArray(arguments))}()) // false
typeof 运算符的结果一共有哪些可能,并说出与 instanceof 的区别?
string/number/undefined/object/function/Boolean/symbol
typeof 判断的是数据类型,返回的是字符串。
Instanceof 判断是否在原型链上,返回的结果是布尔值
JS 的数据类型?怎么检测数据类型的?
Js的基本数据类型有:string、number、boolean、null、undefined,ES6中symbol
复杂数据类型有:object:`Array` ,`Function`, `Date`, `RegExp`

typeof()  intanceof()  constructor()

typeof()测试数据类型的时候结果:
	“number”、“string”、“boolean”、“undefined”、“object”、“function”

如何判断一个元素是否是数组
	1、instanceof 操作符判断
	2、arr.constructor === Array
	3、Array.isArray(arr)
数据类型的判断有哪些方法?他们的优缺点及区别是什么?
然后判断数据类型的方法一般可以通过:typeof、instanceof、constructor、toString四种常用方法
⭐ 3、let 、const、var 的区别?
1、var声明的变量会挂载到window上,而let和const声明的变量不会。
2、var声明变量存在变量声明提升,let和const不存在变量声明提升。
3、let和const声明的变量有块作用域。
4、同一作用域下let和const不能声明同名变量,而var可以。
5、let和const声明的变量存在 会造成暂时性死区。
6、const声明变量的时候必须赋初始值
⭐ 4、变量的声明提升
var有变量声明提升,将变量的声明提升到当前的作用域最开始的位置,但赋值还是在原来位置
函数也存在声明提升.
函数的升明提升优先于变量的声明提升

console.log(a);
var a = 100;
⭐ 5、作用域、作用域链(是什么?)
作用域:变量或者函数可访问的范围
 	全局作用域: 在函数的外部使用var声明的变量,可以在任意位置访问;
 	局部作用域(函数作用域):在函数中使用var关键字声明的变量,只能在函数的内部访问;
	ES6又增加了一种作用域:块级作用域,比如说es6中let和const声明的变量都具有块级作用域

 作用域链: 一般情况下,变量取值会到创建这个变量的函数作用域中取值。但是如果在当前作用域中没有查到值,就会向上级作用域去查,直到查到全局作用域,这么一个查找过程形成的链条就叫做作用域链。
6、Symbol(是什么?用途?)
ES6 引入新的原始数据类型 Symbol,表示独一无二的值
7、JS 的三大组成部分
ECMAscript:主要用来描述javascript的语法部分
BOM:结合js及BOM提供的属性和方法对浏览器进行操作
DOM:结合js及DOM提供的属性和方法对HTML和XML文档进行操作
⭐ 8、JS 强制类型转换
| 方法 | 含义 |
|---|---|
| parseInt() | 转换数值类型 |
| Number() | 转换数值类型 |
| ToString() | 转换字符串类型 |
| Boolean() | 转换对象类型 |
⭐ 9、ES6 新特性?
ES6是2015年推出的一个新的版本、这个版本相对于ES5的语法做了很多的优化

新增了let、const,let和const具有块级作用域,不存在变量提升的问题
新增了箭头函数,简化了定义函数的写法,同时可以巧用箭头函数的this、(注意箭头函数本身没有this,它的this取决于外部的环境)。
新增了promise解决了回调地域的问题
新增了模块化、利用import 、export来实现导入、导出。
新增了解构赋值,ES6 允许按照一定模式,从数组和对象中提取值,对变量进行赋值,这被称为解构(Destructuring)。
新增了class类的概念,它类似于对象。

1.	模块化开发
2.	箭头函数
3.	函数参数默认值
4.	模板字符串
5.	解构赋值
6.	对象属性简写
7.	Promise
8.	let与const
9.	class 类
10.	扩展运算符
11、新增了数组、字符串、对象的方法
12、for...of
10、严格模式的限制?
⭐ 11、普通函数和箭头函数的区别?
区别:
	1、语法不同。
	2、箭头函数是匿名函数,不能作为构造函数,不能使用new。
	3、箭头函数不能绑定arguments,取而代之用rest参数...解决。
	4、箭头函数没有prototype。
	5、箭头函数不绑定this,会捕获其所在的上下文的this值,作为自己的this值。
	6、箭头函数不能当做Generator函数,不能使用yield关键字.
	7、即使调用 call/apply/bind 也无法改变箭头函数的 this
⭐ 12、promise(是什么?用途?)
promise 有几种状态,什么时候会进入 catch
三个状态:pending,fulfilled,rejected
两个过程:pending->fulfilled,pending->rejected.当 pending 为 rejected 时,会进入 catch
Promise 中 reject 和 catch 处理上有什么区别?
Reject 是 promise 的方法,而 catch 是 promise 实例的方法
Reject 是用来抛出异常,catch 是用来处理异常的
Reject 后的东西,一定会进入 then 的第二个回调,如果 then 中没有第二个回调,则进入 catch
Promise是异步编程的一种解决方案,主要解决由于异步请求的多层嵌套造成的回调地狱问题。
解决异步编程的方案:async await  generator promise

async和promise的区别?
答:首先他们的相同点都是异步编程的一种解决方案,async await后面跟一个promise,async主要把异步变为同步,解决了链式操作。

Promise有三个状态和两个过程
	三个状态:pending(初始状态)、fulfilled(成功状态)、rejected(失败状态);

	两个过程:pending==>fulfilled的过程和pending==>rejected的过程。
	缺点:promise的状态一旦改变则不会再变,是不可逆的,无法阻止状态的改变

	方法:Promise是一个构造函数,自身有all、race、reject、resolve这几个方法,原型上有then和catch方法,让异步代码像同步一样执行。


	all方法是:只有所有的promise对象都成功了,就会调then方法,如果有一个是失败的就会调catch方法
	race方法是:如果有一个成功的就会调then方法,如果第一个是失败的就会调catch方法

	什么时候使用all方法:比如:当一个页面有多个ajax请求,想请求结果都成功之后再处理结果。

js他是单线程的,但是它分为同步任务和异步任务,同步任务会放到主线程中去执行,

在ES6中由于增加了promise,所以在异步任务中又分为宏任务和微任务
宏任务:setTimeout、setInterval、requestAnimationFrame
	1、宏任务所处的任务队列就是宏任务队列
	2、第一个宏任务队列中只有一个任务:执行主线程的js代码
	3、宏任务队列可以有多个
	4、当宏任务队列中的任务全部执行完会查看是否有位微务队列,如果有先执行微任务中的所有任务,如果没有就查看是否有宏任务
微任务:promise.then(回调)   process.nexttick(  )
	1、微任务所处的队列就是微任务队列
	2、只有一个微任务队列
	3、在上一个宏任务队列执行完毕后执行,如果有微任务队列就会执行微任务中的所有任务。
		首先在宏任务的队列中选取出第一个任务,执行完毕后取出微任务队列中的所有任务顺序执行,之后再取出宏任务,周而复始,直至两个队列的任务都取完。


		setTimeout(function(){
            console.log(1);
        },0);
        new Promise(function(a,b){
            console.log(2);
            for(var i=0;i<10;i++){
                i==9&&a();
            }
            console.log(3)
        }).then(function(){
            console.log(4)
        });
        console.log(5);

	正确输出顺序为:2,3,5,4,1;

	微任务先执行,宏任务后执行
1. Promise 是异步编程的一种解决方案.简单说就是一个容器,里面保存着某个未来才会结束的事件(通常是一个异步操作)的结果。从语法上说,Promise 是一个对象,可以从改对象获取异步操作的消息。
   它可以解决回调地狱的问题,也就是异步深层嵌套问题
   .catch()
   获取异常信息
   .finally()
   成功与否都会执行(不是正式标准)
   /\*
2. Promise 基本使用
   我们使用 new 来构建一个 Promise Promise 的构造函数接收一个参数,是函数,并
   且传入两个参数: resolve,reject, 分别表示异步操作执行成功后的回调函数
   和异步操作执行失败后的回调函数
   \*/
   var p = new Promise(function(resolve, reject){
   //2. 这里用于实现异步任务 setTimeout
   setTimeout(function(){
   var flag = false;
   if(flag) {
   //3. 正常情况
⭐ 13、async await (是什么?用途?)
async await是es7里面的新语法、它的作用就是async用于申明一个function 是异步的,而await用于等待一个异步方法执行完成。它可以很好的替代promise中的then

async函数返回一个Promise对象,可以使用then方法添加回调函数。当函数执行的时候,一旦遇到await就会先返回,等到异步操作完成,再接着执行函数体内后面的语句。
⭐ 14、原型、原型链(是什么?用途?)
就是实例对象和原型对象之间的链接,每一个对象都有原型,原型本身又是对象,原型又有原型,直到查到 object.protetype.proto为 null 为止。以此类推形成一个链式结构.称为原型链
原型:构造函数的prototype就是构造函数new出来的对象的原型

原型链就是通过原型继承在原型之间建立起来的链型结构被称为原型链
对象属性查找顺序为:
    每一个实例对象都有一个私有属性__proto__,指向它的构造函数的原型对象(prototype)。原型对象也有自己的__proto__,层层向上直到一个对象的原型对象为null。这一层层原型就是原型链。
每一个实例对象上有一个proto属性,指向的构造函数的原型对象,构造函数的原型对象也是一个对象,也有proto属性,这样一层一层往上找的过程就形成了原型链。
⭐ 15、递归(是什么?用途?优缺点?)
递归:如果一个函数在内部可以调用其本身,那么这个函数就是递归函数。简单理解: 函数内部自己调用自己,
  这个函数就是递归函数 优点:结构清晰、可读性强
    缺点:效率低、调用栈可能会溢出,其实每一次函数调用会在内存栈中分配空间,而每个进程的栈的容量是有限的,当调用的层次太多时,就会超出栈的容量,从而导致栈溢出。->性能;
16、== 和 ===的区别
== 	会自动转换类型再去比较值是否相等
===	不会自动转类型,并且进行比较时值与数据类型都要相等
⭐ 17、什么是 mvvm 、 mvc 模型?
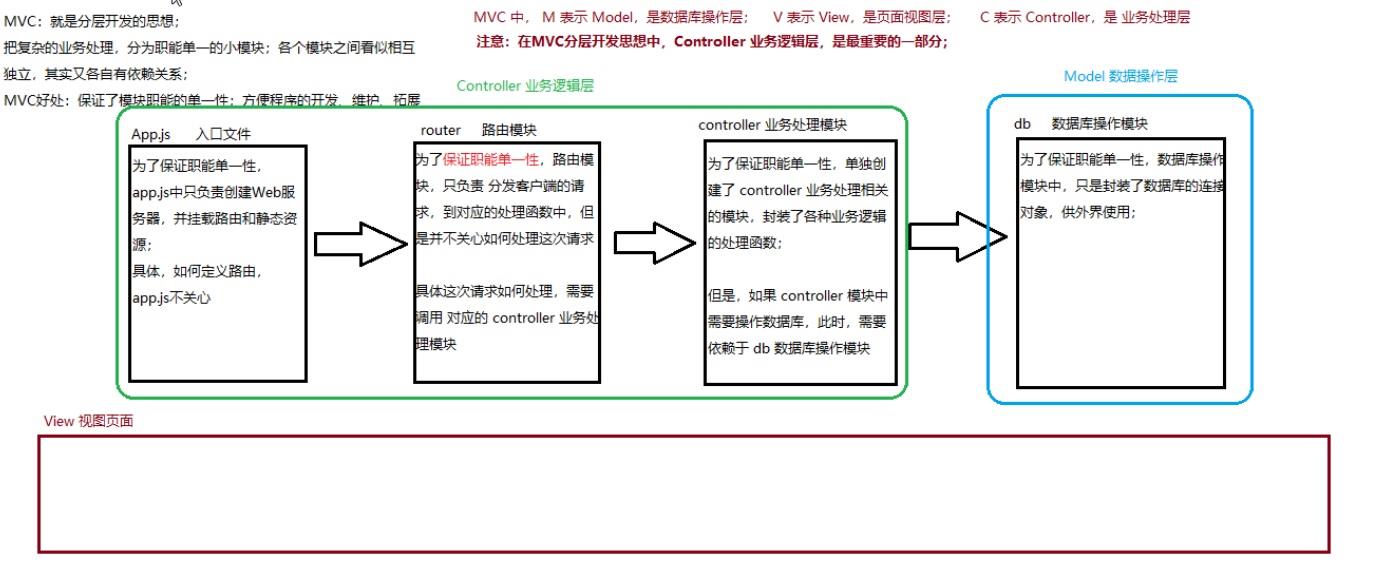
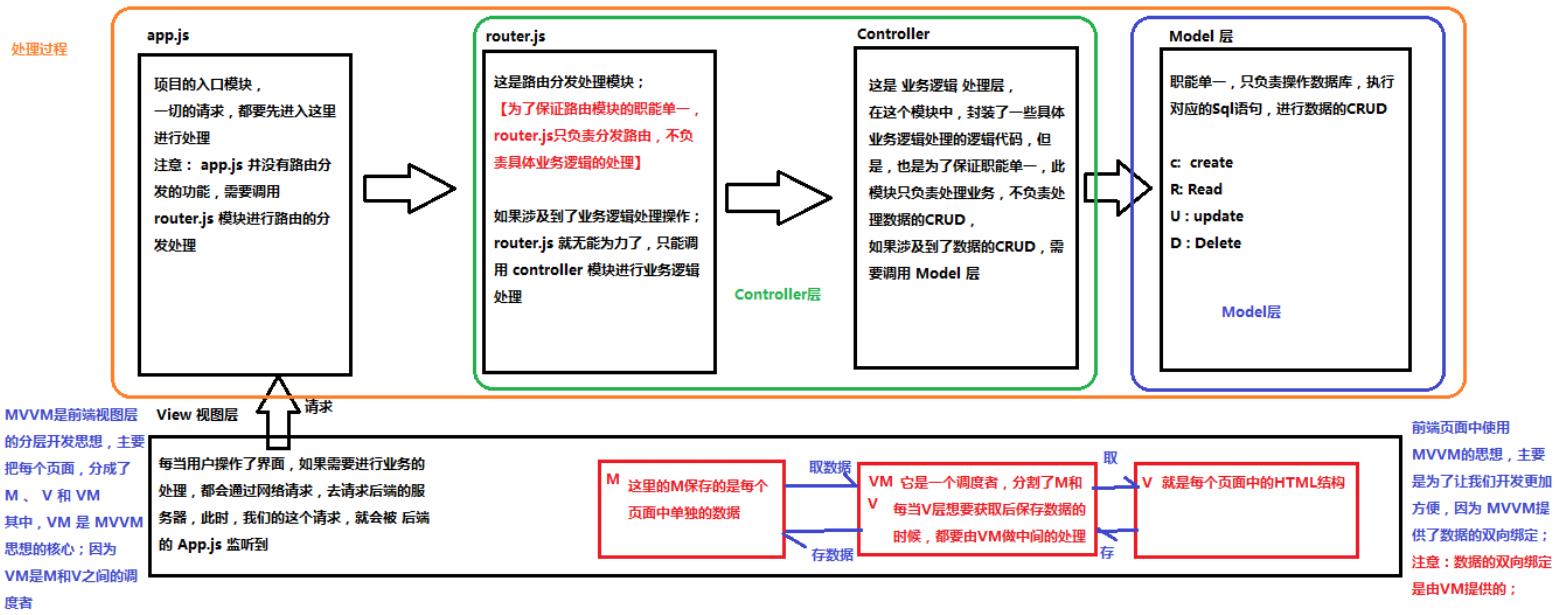
MVC: MVC即model-view-controller(模型-视图-控制器)是项目的一种分层架构思想,它把复杂的业务逻辑,抽离为职能单一的小模块,每个模块看似相互独立,其实又各自有相互依赖关系。它的好处是:保证了模块的职能单一性,方便程序的开发、维护、耦合度低。

mvvm:MVVM即 Model-View-ViewModel,(模型-视图-控制器)它是一种双向数据绑定的模式,用viewModel来建立起model数据层和view视图层的连接,数据改变会影响视图,视图改变会影响数据
⭐ 18、闭包(是什么?用途?优缺点?为什么会导致内存泄漏?怎么解决?)
闭包(closure)指有权访问另一个函数作用域中变量的函数。简单理解就是 ,一个作用域可以访问另外一个函数内部的局部变量。
形成闭包的条件
    1.函数嵌套函数
    2.函数内部调用函数外部的变量
    3.外部的函数被调用
作用:延长变量作用域、在函数的外部可以访问函数内部的局部变量,容易造成内层泄露,因为闭包中的局部变量永远不会被回收
优点:函数外部能够读取函数内部的变量,避免了全局变量被污染
缺点:由于闭包会使函数中的变量保存在内存中,内存消耗很大,而且容易造成内存泄漏
解决办法: 在退出函数前将不使用的局部变量删除,或者直接将赋值的变量等于null(increment()=null)
描述闭包导致的内存泄漏问题的原因:
闭包是外部函数+外部函数声明的变量+内部函数。这样的变量变相的实现了内部函数的私有,变相等同是内部函数的全局变量,而全局变量就不能让垃圾回收机制进行释放,长此以往导致内存不断增加而泄露。
function fn() {
  var num = 10;
  function fun() {
    console.log(num);
  }
  return fun;
}
var f = fn();
f();
⭐ 19、防抖、节流(是什么?怎么处理?)
https://www.cnblogs.com/youma/p/10559331.html

两者都是优化高频率执行js代码的一种手段。
函数防抖(debounce):
	一个需要频繁触发的函数,在规定时间内,只让最后一次生效,前面的不生效。规定时间内再次触发会重新计算(主要应用场景有:input验证、搜索联想、resize)
	(大白话:只执行最后一次)

函数节流(throttle):
	一个函数执行一次后,只有大于设定的执行周期后才会执行第二次。(主要应用场景有:scroll、touchmove)
	(大白话:控制执行次数)
21、什么原因会造成内存泄露?
⭐ 22、重绘、重排\回流(是什么?)
⭐ 23、常用的数组方法有哪些?哪些方法会改变原数组,哪些不会?
concat()方法用于合并两个或多个数组。此方法不会更改现有数组,而是返回一个新数组。
find()方法返回数组中满足提供的测试函数的第一个元素的值。否则返回 undefined 。
findIndex()方法返回数组中满足提供的测试函数的第一个元素的索引。否则返回-1。
includes(方法用来判断一个数组是否包含一个指定的值,根据情况,如果包含则返回 true,否则返回false。
indexOf()方法返回在数组中可以找到一个给定元素的第一个索引,如果不存在,则返回-1。(通常用它判断数组中有没有这个元素)
join()方法将一个数组(或一个类数组对象)的所有元素连接成一个字符串并返回这个字符串。如果数组只有一个项目,那么将返回该项目而不使用分隔符。
pop()方法从数组中删除最后一个元素,并返回该元素的值。此方法更改数组的长度。
push()方法将一个或多个元素添加到数组的末尾,并返回该数组的新长度。
shift()方法从数组中删除第一个元素,并返回该元素的值。此方法更改数组的长度。
unshift()方法将一个或多个元素添加到数组的开头,并返回该数组的新长度(该方法修改原有数组)。
splice()方法通过删除或替换现有元素或者原地添加新的元素来修改数组,并以数组形式返回被修改的内容。此方法会改变原数组。由被删除的元素组成的一个数组。如果只删除了一个元素,则返回只包含一个元素的数组。如果没有删除元素,则返回空数组。
reverse()方法将数组中元素的位置颠倒,并返回该数组。该方法会改变原数组。
sort()方法用原地算法对数组的元素进行排序,并返回数组。默认排序顺序是在将元素转换为字符串,然后比较它们的UTF-16代码单元值序列时构建的
every()方法测试一个数组内的所有元素是否都能通过某个指定函数的测试。它返回一个布尔值。
filter()方法创建一个新数组, 其包含通过所提供函数实现的测试的所有元素。
forEach()方法对数组的每个元素执行一次提供的函数。
some()方法测试是否至少有一个元素可以通过被提供的函数方法。该方法返回一个Boolean类型的值。
22、Split()和 join()的区别?
24、数组有哪几种循环方式?分别有什么作用?
every()方法测试一个数组内的所有元素是否都能通过某个指定函数的测试。它返回一个布尔值。
filter()方法创建一个新数组, 其包含通过所提供函数实现的测试的所有元素。
forEach()方法对数组的每个元素执行一次提供的函数。
some()方法测试是否至少有一个元素可以通过被提供的函数方法。该方法返回一个Boolean类型的值。
25、JS 遇到过哪些兼容性问题
是要处理IE浏览器和非IE浏览器之间的兼容

1、获取滚动距离的兼容处理
	document.documentElement.scrollTop    非IE
    document.body.scrollTop   ==> 兼容IE
2、阻止冒泡的兼容处理
	e.stopPropagation()	非IE   ||    e.cancelBubble 兼容IE
3、阻止默认行为
	preventDefault( ) 非IE  ||  	return  false  兼容IE
4、DOM2添加监听事件的兼容处理
	addEventListener 非IE || attachEvent  兼容IE
5、删除DOM2事件监听
	removeEventListener 非IE  || detachEvent  兼容IE
⭐ 26、 this (this 指向?如何改变 this 指向?)
首先this的指向在函数定义的时候是确定不了的,只有函数执行的时候才能确定this到底指向谁
    在全局的环境中,this指向的是window
    在函数中,有两种情况,非严格情况下普通函数中的this指向window,在严格情况下this指向undefined
    定时器中的this指向window
    在箭头函数中,this指向的是父级程序的this指向,如果没有父级程序或者父级程序没有指向,箭头函数的this指向的是window
    事件中的this指向事件的调用者
    构造函数中this和原型对象中的this,都是指向构造函数new出来实例对象
    类class中的this 指向由constructor构造器new出来的实例对象
    自调用函数中的this 指向window
    在对象中,如果函数被上一级对象调用,那么this指向的是上一级对象,否则指向全局window
    在构造函数中,this指向的是new出来的那个对象
⭐ 27、深拷贝、浅拷贝(是什么?如何实现?)
描述什么是深拷贝,什么是浅拷贝,以及用代码实现深拷贝?
深浅拷贝,针对的都是引用数据类型。深拷贝拷贝的不是地址而是对象。浅拷贝拷贝的是地址,如果是基本数据类型就是只拷贝值。
浅拷贝:创建一个新对象,这个对象有着原始对象属性值的一份精确拷贝。如果属性是基本类型,拷贝
的就是基本类型的值,如果属性是引用类型,拷贝的就是内存地址 ,所以如果其中一个对象改变了这个
地址,就会影响到另一个对象。
深拷贝会拷贝所有的属性,并拷贝属性指向的动态分配的内存。当对象和它所引用的对象一起拷贝时即
发生深拷贝。深拷贝相比于浅拷贝速度较慢并且花销较大。拷贝前后两个对象互不影响。
都是引用数据类型来说的,基本数据类型没有深拷贝和浅拷贝一说
浅拷贝\深拷贝
	浅复制只复制一层对象的属性,而深复制则递归复制了所有层级
						   而深拷贝又分为三种
						   1、可以使用递归
						   2、可以转为JSON串,JSON.stringify,JSON.parse
						   3、可以使用jq中的xtend
						   深拷贝的缺陷:
						   1、如果里面有时间对象,则 JSON.stringify 后再 JSON.parse 的结果,时间							  将转为字符串的形式,而不是对象的形式
						   2、如果数组里面有 RegExp (正则表达式的缩写)、Error 对象,则序列化的结果								 将只得到空对象;

一、对象的深浅拷贝
深拷贝
1、原生实现
function deepCopy(p,c){
    var i;
    c = c||{};
    for(i in p){
        if(p.hasOwnProperty(i)){
            if(typeof(p[i])==="object"){
                c[i] = Array.isArray(p[i])?[]:{};
                deepCopy(p[i],c[i]);
            }else{
                c[i] = p[i];
           }
        }
    }
    return c;
}

2、使用 JSON 全局对象的 parse 和 stringify 方法来实现深复制
    function jsonClone(obj) {
        return JSON.parse(JSON.stringify(obj));
    }
    var clone = jsonClone({ a:1 });
 (https://www.cnblogs.com/kongxy/p/4618173.html)
 对象的属性分为可枚举和不可枚举之分,它们是由属性的enumerable值决定的。可枚举性决定了这个属性能否被for…in查找遍历到。for...in遍历可枚举的属性和原型链上的可枚举的属性。
这种方法有一个缺点就是只能复制对象中的可枚举属性,其他属性不可复制,例如function。这种简单粗暴的方式有局限性,当值为undefined、function、symbol会在转换过程中被忽略。

这时可以采用如下方法:
function getType(obj) {
  //tostring会返回对应不同的标签的构造函数
  var toString = Object.prototype.toString;
  var map = {
    '[object Boolean]'  : 'boolean',
    '[object Number]'   : 'number',
    '[object String]'   : 'string',
    '[object Function]' : 'function',
    '[object Array]'    : 'array',
    '[object Date]'     : 'date',
    '[object RegExp]'   : 'regExp',
    '[object Undefined]': 'undefined',
    '[object Null]'     : 'null',
    '[object Object]'   : 'object'
  };
  if(obj instanceof Element) {
    return 'element';
  }
  return map[toString.call(obj)];
}

function deepCopy(obj) {
  var type = getType(obj);
  var obj;
  if(type === 'array'){
    obj = [];
  } else if(type === 'object'){
    obj = {};
  } else {
    //不再具有下一层次
    return obj;
  }
  if(type === 'array'){
    for(var i = 0, len = obj.length; i < len; i++){
      obj.push(deepCopy(obj[i]));
    }
  } else if(type === 'object'){
    for(var key in obj){
      obj[key] = deepCopy(obj[key]);
    }
  }
  return obj;
}

3、$.extend(),设置为true是深拷贝
var x = {
    a: 1,
    b: { f: { g: 1 } },
    c: [ 1, 2, 3 ]
};

var y = $.extend({}, x),          //shallow copy
    z = $.extend(true, {}, x);    //deep copy

y.b.f === x.b.f       // true
z.b.f === x.b.f       // false

4、Object.assign(...)

对象的浅拷贝
1、自己封装函数实现
 var obj = { a:1, arr: [2,3] };
 var shallowObj = shallowCopy(obj);

function shallowCopy(src) {
  var dst = {};
  for (var prop in src) {
    if (src.hasOwnProperty(prop)) {
      dst[prop] = src[prop];
    }
  }
  return dst;
}
2、直接赋值
	var obj = {a:1};
	var obj1 = obj;
二、数组的深浅拷贝
浅拷贝
1、直接赋值
	var arr = [12,34,343];
	var arr1 = arr;
2、自己封装函数实现

深拷贝
1、自己封装函数实现
2、slice()
// 当数组里面的值是基本数据类型,比如String,Number,Boolean时,属于深拷贝
// 当数组里面的值是引用数据类型,比如Object,Array时,属于浅拷贝
3、concat()
// 当数组里面的值是基本数据类型,比如String,Number,Boolean时,属于深拷贝
4、使用扩展运算符实现深拷贝
// 当value是基本数据类型,比如String,Number,Boolean时,是可以使用拓展运算符进行深拷贝的
// 当value是引用类型的值,比如Object,Array,引用类型进行深拷贝也只是拷贝了引用地址,所以属于浅拷贝
28、后台管理系统中的权限管理是怎么实现的?
登录:当用户填写完账号和密码后向服务端验证是否正确,验证通过之后,服务端会返回一个token,拿到token之后(我会将这个token存贮到cookie中,保证刷新页面后能记住用户登录状态),前端会根据token再去拉取一个 user_info 的接口来获取用户的详细信息(如用户权限,用户名等等信息)。

权限验证:通过token获取用户对应的 权限,动态根据用户的 权限算出其对应有权限的路由,通过router.addRoutes 动态挂载这些路由。

具体思路:
登录成功后,服务端会返回一个 token(该token的是一个能唯一标示用户身份的一个key),之后我们将token存储在本地cookie之中,这样下次打开页面或者刷新页面的时候能记住用户的登录状态,不用再去登录页面重新登录了。

ps:为了保证安全性,我司现在后台所有token有效期(Expires/Max-Age)都是Session,就是当浏览器关闭了就丢失了。重新打开游览器都需要重新登录验证,后端也会在每周固定一个时间点重新刷新

token,让后台用户全部重新登录一次,确保后台用户不会因为电脑遗失或者其它原因被人随意使用账号。用户登录成功之后,我们会在全局钩子 router.beforeEach 中拦截路由,判断是否已获得token,在获得token之后我们就要去获取用户的基本信息了页面会先从 cookie 中查看是否存有 token,没有,就走一遍上一部分的流程重新登录,如果有token,就会把这个 token 返给后端去拉取user_info,保证用户信息是最新的。 当然如果是做了单点登录得功能的话,用户信息存储在本地也是可以的。当你一台电脑登录时,另一台会被提下线,所以总会重新登录获取最新的内容。
先说一说我权限控制的主体思路,前端会有一份路由表,它表示了每一个路由可访问的权限。当用户登录之后,通过 token 获取用户的 role ,动态根据用户的 role 算出其对应有权限的路由,再通过router.addRoutes 动态挂载路由。但这些控制都只是页面级的,说白了前端再怎么做权限控制都不是绝对安全的,后端的权限验证是逃不掉的。
我司现在就是前端来控制页面级的权限,不同权限的用户显示不同的侧边栏和限制其所能进入的页面(也做了少许按钮级别的权限控制),后端则会验证每一个涉及请求的操作,验证其是否有该操作的权限,每一个后台的请求不管是 get 还是 post 都会让前端在请求 header 里面携带用户的 token,后端会根据该 token 来验证用户是否有权限执行该操作。若没有权限则抛出一个对应的状态码,前端检测到该状态码,做出相对应的操作。
使用vuex管理路由表,根据vuex中可访问的路由渲染侧边栏组件。
具体实现:
创建vue实例的时候将vue-router挂载,但这个时候vue-router挂载一些登录或者不用权限的公用的页面。
当用户登录后,获取用role,将role和路由表每个页面的需要的权限作比较,生成最终用户可访问的路由表。
调用router.addRoutes(store.getters.addRouters)添加用户可访问的路由。
使用vuex管理路由表,根据vuex中可访问的路由渲染侧边栏组件。
⭐ 29、常用的字符串方法有哪些?
charAt() 方法从一个字符串中返回指定的字符。
concat() 方法将一个或多个字符串与原字符串连接合并,形成一个新的字符串并返回。
includes() 方法用于判断一个字符串是否包含在另一个字符串中,根据情况返回 true 或 false。
indexOf() 方法返回调用它的 String 对象中第一次出现的指定值的索引,从 fromIndex 处进行搜索。如果未找到该值,则返回 -1。
match() 方法检索返回一个字符串匹配正则表达式的的结果。
padStart() 方法用另一个字符串填充当前字符串(重复,如果需要的话),以便产生的字符串达到给定的长度。填充从当前字符串的开始(左侧)应用的。 (常用于时间补0)
replace() 方法返回一个由替换值( replacement )替换一些或所有匹配的模式( pattern )后的新字符串。模式可以是一个字符串或者一个正则表达式,替换值可以是一个字符串或者一个每次匹配都要调用的回调函数。原字符串不会改变。
slice() 方法提取某个字符串的一部分,并返回一个新的字符串,且不会改动原字符串。
split() 方法使用指定的分隔符字符串将一个 String 对象分割成字符串数组,以将字符串分隔为子字符串,以确定每个拆分的位置。
substr()方法返回一个字符串中从指定位置开始到指定字符数的字符。
trim() 方法会从一个字符串的两端删除空白字符。在这个上下文中的空白字符是所有的空白字符(space, tab, no-break space 等) 以及所有行终止符字符(如 LF,CR)。
数组和字符串常用方法
| 方法 | 含义 | 发音/邪音 |
|---|---|---|
| concat() | 将多个数组拼接成一个数组 | |
| join() | 将数组转化为字符串 | |
| pop() | 删除数组最后一个元素 | |
| shift() | 删除数组第一个元素 | |
| reverse() | 数组翻转 | |
| push() | 数组末尾添加元素 | |
| unshift() | 数组开头添加元素 | |
| sort() | 数组排序 | |
| indexOf() | 主要用于在数组中查找数组元素第一次出现的位置 | |
| lastIndexOf() | 主要用于在数组中查找数组元素最后一次出现的位置 | |
| splice() | 方法向/从数组中添加/删除项目,然后返回被删除的项目 | |
| slice() | 以从数组中返回 start 下标开始取值,直到 end 下标结束. | |
| filter() | 过滤器,留下符合条件的会形成一个新数组 | |
| map() | 主要用于对每个数组里面的元素执行相同的函数来创建新的数组 | |
| some() | 方法用于检测数组中的元素是否满足指定条件,返回值为布尔类型 | |
| every() | 主要用于检查数组中每个元素是否符合函数的条件,如果其中有一个不符合,则返回 false | |
| reduce() | 求和操作,主要是对数组中的每个元素执行函数,生成一个值。 | |
| flat() | 将多维数组转成一维数组 | |
| find() | 查找数组第一个符合条件的元素 | |
| findIndex() | 查找数组第一个符合条件的元素的下标 | |
| from() | 将类数组转真正的数组 | |
| 方法 | 含义 | 发音/邪音 |
| substring() | 截取字符串 | |
| charAt() | 查找字符串 | |
| toUpperCase() | 转大写 | |
| toLowerCase() | 转小写 | |
| split() | 字符串转数组 | |
| indexOf() | 返回子字符串第一次出现的位置 | |
| lastIndexOf() | 返回子字符串最后一次出现的位置 | |
| slice() | 截取字符串 | |
| replace() | 字符串替换 | |
| padStart() | 用于头部补全 | |
| padEnd() | 用于尾部补全 | |
| trimStart() | 消除字符串头部的空格 | |
| trimEnd() | 消除尾部的空格` | |
| trim() | 方法用于删除字符串的头尾空白符 | |
| repeat() | ||
| startsWith() | 返回布尔值,表示参数字符串是否在原字符串的头部。 | |
| endsWith() | 返回布尔值,表示参数字符串是否在原字符串的尾部。 |
⭐ 30、了解 Eventloop(事件循环)吗?
js是单线程语言,一次只能完成一个任务,如果同时完成多个任务怎么办?js把任务分为同步和异步任务,把所有的同步放到主线程上去执行,把所有的异步任务放到事件队列里去,当所有的同步任务都执行完之后,去事件队列中看看有没有没有执行的异步任务,如果有把需要先执行的异步任务拉到主线程上去执行,当这个任务执行完后,再去事件队列里看有没有没完成的任务,如果有再把任务拉到主线程去执行,这样就形成一个事件循环。


js他是单线程的,但是它分为同步任务和异步任务,同步任务会放到主线程中去执行,

在ES6中由于增加了promise,所以在异步任务中又分为宏任务和微任务
宏任务:setTimeout、setInterval、requestAnimationFrame
	1、宏任务所处的任务队列就是宏任务队列
	2、第一个宏任务队列中只有一个任务:执行主线程的js代码
	3、宏任务队列可以有多个
	4、当宏任务队列中的任务全部执行完会查看是否有位任务队列,如果有先执行微任务中的所有任务,如果没有就查看是否有宏任务
微任务:promise.then(回调)   process.nexttick(  )
	1、微任务所处的队列就是微任务队列
	2、只有一个微任务队列
	3、在上一个宏任务队列执行完毕后执行,如果有为任务队列就会执行微任务中的所有任务。
		首先在宏任务的队列中选取出第一个任务,执行完毕后取出为任务队列中的所有任务顺序执行,之后再取出宏任务,周而复始,直至两个队列的任务都取完。


		setTimeout(function(){
            console.log(1);
        },0);
        new Promise(function(a,b){
            console.log(2);
            for(var i=0;i<10;i++){
                i==9&&a();
            }
            console.log(3)
        }).then(function(){
            console.log(4)
        });
        console.log(5);

	正确输出顺序为:2,3,5,4,1;
31、js 的执行机制是怎么样的?
js 是一个单线程、异步、非阻塞 I/O 模型、 event loop 事件循环的执行机制。所有任务可以分成两种,一种是同步任务(synchronous),另一种是异步任务(asynchronous)。
同步任务指的是,在主线程上排队执行的任务,只有前一个任务执行完毕,才能执行后一个任务。
异步任务指的是,不进入主线程、而进入"任务队列"(task queue)的任务,只有"任务队列"通知主线程,某个异步任务可以执行了,该任务才会进入主线程执行。
32、JS 创建对象的方法
0,字面量方式
1. new一个对象
2,工厂函数方式
3,构造函数模式
4,原型模式
5,混合构造函数和原型模式
6,动态原型模式
7,寄生构造函数模式
8,稳妥构造函数模式
33、JS 实现继承的方式?
1,原型链继承
2,借用构造函数继承
3,组合继承(原型+借用构造)
4,原型式继承
5,寄生式继承
6,寄生组合式继承
一、原型链继承
特点:1、实例可继承的属性有:实例的构造函数的属性,父类构造函数属性,父类原型的属性。(新
实例不会继承父类实例的属性!
缺点:1、新实例无法向父类构造函数传参。
2、继承单一。
3、所有新实例都会共享父类实例的属性。(原型上的属性是共享的,一个实例修改了原型属
性,另一个实例的原 型属性也会被修改!)
二、借用构造函数继承
function fn() {
  var num = 10;
  function fun() {
    console.log(num);
 }
  return fun;
}
var f = fn();
f();
重点:用.call()和.apply()将父类构造函数引入子类函数(在子类函数中做了父类函数的自执行(复
制))
特点:1、只继承了父类构造函数的属性,没有继承父类原型的属性。
2、解决了原型链继承缺点1、2、3。
3、可以继承多个构造函数属性(call多个)。
4、在子实例中可向父实例传参。
缺点:1、只能继承父类构造函数的属性。
2、无法实现构造函数的复用。(每次用每次都要重新调用)
3、每个新实例都有父类构造函数的副本,臃肿。
三、组合继承(组合原型链继承和借用构造函数继承)(常用)
重点:结合了两种模式的优点,传参和复用
特点:1、可以继承父类原型上的属性,可以传参,可复用。
2、每个新实例引入的构造函数属性是私有的。
缺点:调用了两次父类构造函数(耗内存),子类的构造函数会代替原型上的那个父类构造函
数。
四、原型式继承
重点:用一个函数包装一个对象,然后返回这个函数的调用,这个函数就变成了个可以随意增添属性的
实例或对象。object.create()就是这个原理。
特点:类似于复制一个对象,用函数来包装。
缺点:1、所有实例都会继承原型上的属性。
2、无法实现复用。(新实例属性都是后面添加的)
五、class类实现继承
通过extends 和super 实现继承
六、寄生式继承
重点:就是给原型式继承外面套了个壳子。
优点:没有创建自定义类型,因为只是套了个壳子返回对象(这个),这个函数顺理成章就成
了创建的新对象。
缺点:没用到原型,无法复用。
34、前端性能优化的方法?
使用懒加载、使用雪碧图、动态渲染组件、CDN 加载包。
  1. 当需要设置的样式很多时设置className,而不是直接操作style。
  2. 避免在页面的主题布局中使用table,table要等其中的内容完全下载之后才会显示出来,显示比div+css布局慢。
  3. 用innerHTML代替DOM操作,减少DOM操作次数,优化javascript性能。
  4. 减少http请求次数,合理设置http缓存;CSS Sprites,JS、CSS源码压缩,图片大小控制合适;网页GZIP压缩,CDN托管,data缓存,图片服务器。
  5. 图片预加载,将样式表放在顶部,将脚本放在底部,加上时间戳。
  6. 前端模板 JS+数据,减少由于html标签导致的贷款浪费,前端用变量保存AJAX请求结果,每次操作本地数据,减少请求次数。
  7. 少用全局变量,缓存DOM节点查找的结果。减少IO(输入/输出)读取操作。
  8. 避免使用CSS Expression(css 表达式)又称动态属性(Dynamic properties)。
  9. 部署前,图片压缩、代码压缩;优化js代码结构,减少冗余代码;减少http请求使用内容分发cdn加速;静态资源缓存;图片延迟加载;动态渲染组件
v-for 遍历避免同时使用 v-if
keep-alive 缓存页面
细分 vuejs 组件降低耦合性
使用 better-click 防止 iphone 点击延迟
减少网络请求
图片懒加载
路由懒加载
比如我们使用的 Element Ui 的时候 使用第三方插件按需引入,不是全部引入
使用 CND 资源
使用骨架屏提高用户体验
开启 gzip 压缩
减少请求次数。
页面优化:
1、使用 cdn 引入。
2、使用图片懒加载、路由懒加载、组件懒加载。
3、使用 gzip 压缩。
4、减少请求次数。
5、利用缓存。
6、使用 dns 预解析。
1.编码优化:
1.不要将所有的数据都放在data中,data中的数据都会增加getter和setter,会收集对应的watcher
2.vue 在 v-for 时给每项元素绑定事件需要用事件代理
3.SPA页面采用keep-alive缓存组件
4.拆分组件( 提高复用性、增加代码的可维护性,减少不必要的渲染 )
5.v-if 当值为false时内部指令不会执行,具有阻断功能,很多情况下使用v-if替代v-show
6.key保证唯一性 ( 默认vue会采用就地复用策略 )
7.Object.freeze 冻结数据
8.合理使用路由懒加载、异步组件
9.尽量采用runtime运行时版本
10.数据持久化的问题 (防抖、节流)
2.Vue 加载性能优化:
第三方模块按需导入 (babel-plugin-component)
滚动到可视区域动态加载 ( https://tangbc.github.io/vue-virtual-scroll-list )
图片懒加载 (https://github.com/hilongjw/vue-lazyload.git)
3.用户体验:
app-skeleton 骨架屏 loading 等
app-shellapp 壳 就是 app 的壳,先渲染 app 的头部和导航
pwa 实现 H5 的离线缓存 serviceworker
4.SEO 优化:
预渲染插件 prerender-spa-plugin
服务端渲染 ssr 5.打包优化:
使用 cdn 的方式加载第三方模块
多线程打包 happypack
splitChunks 抽离公共文件
sourceMap 生成 6.缓存,压缩
客户端缓存、服务端缓存
服务端 gzip 压缩
35、forEach()和 map()和 every()和 some()和 filter()的区别
首先forEach、map、filter、some都是遍历数组的方法,都是用来遍历数组。
forEach,没有返回值
	不能响应return、break
map:返回值为新的数组
	按照原数组的元素顺序依次处理元素,返回一个处理后的新数组,数组元素是值类型则原数组不变,数组元素为引用类型,则原数组改变
filter:返回值为新的数组
	过滤指定数组中所有符合条件的元素,返回一个新数组,原数组不变
some:返回值为boolean类型
	用于检测数组中的元素是否满足指定条件,如果有一个符合条件的就返回true,如果没有符合条件的就返回false,原数组不变

every:返回值为boolean类型
	every用于检测数组中的元素是否满足指定条件,所有元素都符合条件才返回true,如果没有符合条件的返回		false,原数组不变。
⭐ 36、call( ) 、apply( )、bind( )的区别?
共同点:
    三者的用法都是修改this的指向,然后第一个参数都是this指向谁。但是 call,apply,只是临时的修改一次,不改变原函数的指向。bind 是永久的修改函数this指向,但是修改的不是原来的函数。而是返回一个修改后的函数,所以需要调用,函数的 this 永远发生了改变,绑定就修改不了了。

不同点:
    执行方式不一样:call和apply是改变后页面加载立即执行,是同步代码。bind 是异步代码,改变后不会立即执行。而是返回新的函数。
    传递参数方式不同:call和bind第二个参数是一个序列模式的,依次传入,不能使用剩余参数的方式传参。Apply第二个参数是一个数组的格式,只要是数组方式就可以使用剩余参数。
	call和apply会调用函数 bind不会调用函数。

应用场景:
    1.call经常做继承
    2.apply经常跟数组有关系. 比如借助于数学对象实现数组最大值最小值
    3.bind不调用函数,但是还想改变this指向. 比如改变定时器内部的this指向
var obj = {
  title: "hello",
  say: function (name, from) {
    console.log(this.title);
    console.log(from);
    console.log(name);
  },
};

var obj2 = {
  title: "你好",
};

obj.say.call(obj2, "张三", "北京"); //传参方式为序列
obj.say.apply(obj2, ["李四", "上海"]); //传参方式为数组
obj.say.bind(obj2, "王五", "深圳")();
37、new 关键字的执行过程
(一)	首先创建一个空对象
(二)	将这个空对象赋值给this,并将this的__proto__指向构造方法对象的原型
(三)	对this这个对象进行属性的添加,并初始化
(四)	将this对象返回
38、自己实现 bind 函数
39、setTimeout 和 setInterval 的区别?
	1.setInterval在执行完一次代码之后,经过了那个固定的时间间隔,它还会自动重复执行代码,而setTimeout只执行一次那段代码。
	setTimeout用于延迟执行某方法或功能
	setInterval则一般用于刷新表单,对于一些表单的假实时指定时间刷新同步
40、知道 lodash 吗?它有哪些常见的 API ?
Lodash 是一个一致性、模块化、高性能的 JavaScript 实用工具库。
_.cloneDeep 深度拷贝
_.reject 根据条件去除某个元素。
_.drop(array, [n=1] ) 作用:将 array 中的前 n 个元素去掉,然后返回剩余的部分.
77、浏览器的缓存
https://www.sohu.com/a/280389359_120047065
78、if 有作用域吗
看情况
首先如果if只有一条语句的话 是不用加大括号的 没有大括号就是没有作用域
如果有大括号就是有作用域(函数作用域)
41、面向对象
面向对象的方法主要是把事物给对象化,具有相同的属性和方法。
面向对象三个特征:
1、封装、
 平时所用的方法和类都是一种封装
2、继承
 子类继承父类,子类拥有父类的属性和方法。

js如何实现继承:原型链继承(prototype)、构造函数继承(call)、组合继承 .....

es6 定义类使用 class关键字  继承使用 extends

 3、多态
一个类的方法,不同对象调用,结果不同
42、js 的内置对象
number、Boolean、String、Data、Array
43、平时都是用那些工具进行打包的?babel 是什么?
WebPack 是一个模块打包工具,你可以使用 WebPack 管理你的模块依赖,并编绎输出模块们所需的静态文件。它能够很好地管理、打包 Web 开发中所用到的 HTML、Javascript、CSS 以及各种静态文件(图片、字体等),让开发过程更加高效。对于不同类型的资源,webpack 有对应的模块加载器。webpack模块打包器会分析模块间的依赖关系,最后 生成了优化且合并后的静态资源
babel 可以帮助我们转换一些当前浏览器不支持的语法,它会把这些语法转换为低版本的语法以便浏览器识别。
⭐ 44、map 和 set 的区别
Map:Map对象保存键值对。任何值(对象或者原始值) 都可以作为一个键或一个值。构造函数`Map`可以接受一个数组作为参数。
Set:Set对象允许你存储任何类型的值,无论是原始值或者是对象引用。它类似于数组,但是成员的值都是唯一的,没有重复的值。
set 是es6 提供的一种新的数据结构,它类似于数组,但是成员的值都是唯一的。
map 是es6 提供的一种新的数据结构,它类似于对象,也是键值对的集合,但是键的范围不仅限于字符
串,各种类型的值都可以当做键。也就是说,Object 结构提供了“字符串—值”的对应,Map 结构提供
了“值—值”的对应,是一种更完善的 Hash 结构实现。如果你需要“键值对”的数据结构,Map 比 Object
更合适。
45、forEach、for in、for of 的区别?
for。。。in的特点:
    1.index索引为字符串型数字,不能直接进行几何运算。
    2.遍历顺序有可能不是按照实际数组的内部顺序。
    3.使用for in会遍历数组所有的可枚举属性,包括原型。所以for in更适合遍历对象,不要使用for in遍历数组。
    对象的遍历(for...in..  keys() values() entries())
for…of的特点:
    for..of适用遍历数/数组对象/字符串/map/set等拥有迭代器对象的集合.但是不能遍历对象,因为对象没有迭代器.与forEach()不同的是,它可以正确响应break、continue和return语句
    for-of循环不支持普通对象,如果要迭代一个对象的属性,可以用for-in循环(这也是它的本职工作)或内建的Object.keys()方法

forEach更多的用来遍历数组

for in 一般常用来遍历对象或json

for of数组对象都可以遍历,遍历对象需要通过和Object.keys()

for in循环出的是key,for of循环出的是value
 forEach专门用来循环数组
 for...in 一般循环遍历的都是对象的属性
 for of是ES6新引入的特性。修复了ES5中for in的不足
 允许遍历 Arrays(数组)、Strings(字符串)、Maps(映射)、Sets(集合)等可迭代的数据结构
 for of 支持return, 只能遍历数组不能遍历对象(遍历对象需要通过和Object.keys()搭配使用)
For in 和 for of 的异同点?
for in 可以遍历对象,for of 不能遍历对象,只能遍历带有迭代器接口的,比如 set,map,string,array
for in 和 for of 都可以循环数组,for in 输出的是数组的 index 下标,而 for of 输出的是数组的每一项的值。
46、事件对象和 this 关键字有什么共同点和不同点
共同点都是 DOM 对象,可以调用
不同点就是事件对象是事件的状态,而 this 关键字指向的是事件的调用者。事件会冒泡,this 因此而变化,但是事件对象不会变化,它是直接接受事件的目标 DOM 元素。
47、描述 es5 的继承和 es6 继承的区别
Es5 是先创建子类,实例化父类并且添加到子类 this 中实现继承。而 es6 是先创建父类,实例化子级通过调用 super 方法访问父类后,通过修改 this 实现继承
48、简单描述什么是事件循环?
Js 代码的执行是单线程的,会将代码任务划分为同步任务(微任务)和异步任务(宏任务)。微任务会优先放到主线程上执行,而宏任务会放置在后执行的队列上。等微任务依次全部完成后,再将宏任务依次放到任务执行队列上,再确定正在执行的宏任务是否包含微任务和宏任务,遵循有微则微,无微则宏形成不断循环的事件。
49、所有对象都有原型,这句话正确还是错误 错误,object 没有原型是 null
⭐ 50、AMD、CMD 规范的区别?
AMD(Modules/Asynchronous-Definition)
CMD(Common Module Definition)
40、请描述一下 ES6 中的 class 类?
es6中的class可以把它看成是es5中构造函数的语法糖,它简化了构造函数的写法, 类的共有属性放到
constructor 里面

1. 通过class 关键字创建类, 类名我们还是习惯性定义首字母大写
   data: {
   },
    methods: {
   }
   });
     </script>
   </body>
   </html>

2. 类里面有个constructor 函数,可以接受传递过来的参数,同时返回实例对象
3. constructor 函数 只要 new 生成实例时,就会自动调用这个函数, 如果我们不写这个函数,类也会自
   动生成这个函数
4. 多个函数方法之间不需要添加逗号分隔
5. 生成实例 new 不能省略
6. 语法规范, 创建类 类名后面不要加小括号,生成实例 类名后面加小括号, 构造函数不需要加function
7. 继承中,如果实例化子类输出一个方法,先看子类有没有这个方法,如果有就先执行子类的
8. 继承中,如果子类里面没有,就去查找父类有没有这个方法,如果有,就执行父类的这个方法(就近
   原则)
9. 如果子类想要继承父类的方法,同时在自己内部扩展自己的方法,利用super 调用 父类的构造函
   数,super 必须在子类this之前调用
10. 时刻注意this的指向问题,类里面的共有的属性和方法一定要加this使用.
11. constructor中的this指向的是new出来的实例对象
12. 自定义的方法,一般也指向的new出来的实例对象
13. 绑定事件之后this指向的就是触发事件的事件源
14. 在 ES6 中类没有变量提升,所以必须先定义类,才能通过类实例化对象
DOM
1、什么是 dom?
1、DOM 是 W3C(万维网联盟)的标准
2、DOM 定义了访问 HTML 和 XML 文档的标准
相关信息
什么是 W3C
1、“W3C 文档对象模型 (DOM) 是中立于平台和语言的接口,它允许程序和脚本动态地访问和更新文档的内容、结构和样式。”
2、W3C DOM 标准被分为 3 个不同的部分
2.1)核心 DOM - 针对任何结构化文档的标准模型
2.2)XML DOM - 针对 XML 文档的标准模型
2.3)HTML DOM - 针对 HTML 文档的标准模型
备注:DOM 是 Document Object Model(文档对象模型)的缩写
2、dom 节点的 Attribute 和 Property 有何区别?(必会)
什么是 Property
每 个 DOM 节点都是一个 object 对象,有自己的 property 和 method,原则上 property 应该仅供 js 操作, 不会出现在 html 中( 默认属性除外: id/src/href/className/dir/title/lang 等),和其他 js object 一样,自定义的 property 也会出现在 object 的 for…in 遍历中
什么是 Attribute
attribute 出现 在 dom 中,js 提供了 getAttribute/setAttribute 等方法来获取和改变它的值,最后作用于 html 中,可以影响 innerHTML 获取的值。可以通过访问 dom 节点的 attributes 属性来获取 改节点的所有的 attribute。(在 IE<9 中,attribute 获取和改变的实际上是 property。)
两者之间的区别是
自定义的 Property 与 Attribute 不同步,不相等 3.2)非自定义的 DOM property 与 attributes 是有条件同步的
非自定义的属性(id/src/href/name/value 等),通过 setAttribute 修改其特性值可以同步作用到 property 上,而通过.property 修改属性值有的(value)时候不会同步到 attribute 上,即不会反应到 html 上(除以下几种情况,非自定义属性 在二者之间是同步的)。
3、dom 结构操作怎样添加、移除、移动、复制、创建和查找节点?
创建新节点
createDocumentFragment() //创建一个 DOM 片段 createElement() //创建一个具体的元素 createTextnode() //创建一个文本节点
添加、移除、替换、插入
appendChild() removeChild() replaceChild()
insertBefore() //并没有 insertAfter()
查找
getElementsByTagName() //通过标签名称
getElementsByName() //通过元素的 Name 属性的值(IE 容错能力较强,会得到一个数组,其中包括 id 等于 name 值的)
getElementById() //通过元素 Id,唯一性
4、dom 事件模型?
DOM 事件模型分为两种:事件捕获和事件冒泡。
事件捕获以点击事件为例,同类型事件会由 根—>目标的祖先素—>目标的父元素—>目标
元素
事件冒泡和事件捕获截然相反。从内到外依次触发:目标元素—>目标元素的父元素—>父元
素的父元素—>根事件传播
事件捕获和事件冒泡都有事件传播阶段,传播阶段就是事件从触发开始到结束的过程。优先级:先捕获,再冒泡。
两种传播方式的来源:W3C 推行 DOM2 级事件之前网景和 IE 在打架,网景用的事件传播方式是捕获,IE 用的事件传播方式是冒泡
5.如何用 JS 获取一个盒子的宽高?
var box = document.getElementById("box")
//获取元素设置的高度,为带单位的字符串类型
var contentHeight = window.getComputedStyle(box,null).height
//获取元素设置的高度,为不带单位的数值类型
box.clientHeight
//获取盒子自身实际高度,为不带单位的数值类型
box.offsetHeight
6、dom 如何实现浏览器内多个标签页之间的通信
7、如何阻止事件冒泡
非IE浏览器使用stopPropagation()方法可以清除事件冒泡		邪音:思倒破 破破给甚
IE浏览器使用cancelBubble()清除事件冒泡
8、常见的 dom 操作?
| 方法 | 含义 | 发音/邪音 |
|---|---|---|
| createElement(‘div’) | 创建 dom 元素 | 亏爱特 爱里们特 |
| appendChild() | 把节点添加到某元素中 | 额喷的 拆哦的 |
| parentNode | 寻找父节点 | 拍润特 耨的 |
| remove() | 删除节点 | 瑞 木屋 |
| removeChild() | 删除子节点 | 瑞木屋 球儿得 |
| insertBefore() | 之前插入子节点 | |
| children | 所有子节点 | |
| nodeType | 节点类型 | |
9、描述什么是事件委托(代理)
时间委托就是利用时间冒泡,只指定一个事件处理程序,绑定在父级元素上,就可以管理某一个类型的所有事件,且是动态的。
10、window.onload 和$(document).ready()的区别。
1、window.onload和ready都是属于就绪函数、区别是window.onload只执行一次、ready会执行多次。
2、window.onload是在页面资源(比如图片和媒体资源都加载完成再执行,它的加载速度远慢于DOM的加载速度)
3、ready是在dom树结构加载完成后就会执行
4、所以ready要比onload要先执行
网络 | 服务
⭐ 1、同源、同源策略
同源就是同协议、同域名、同端口
同源策略是浏览器的一个重要的安全策略,浏览器不允许访问不同源的资源。如果缺少了同源策略,浏览器很容易受到 XSS、 CSFR 等攻击。由 Netscape 公司 1995 年引入浏览器,它是浏览器最核心也最基本的安全功能,现在所有支持 JavaScript 的浏览器都会使用这个策略.
⭐ 2、跨域、跨域解决方案
跨域:
	访问了不同源的资源就是跨域,产生了安全风险,进而阻止了你继续使用该接口的数据。浏览器对ajax请求的一种安全限制。(比如我们现在的项目都是前后端分离的项目,前端的地址和后端的地址不一样,就会产生跨域 )如: http://localhost:8080   http://localhost:3000
跨域的解決方案:
跨域分为:前端跨域、后端跨域、线上跨域、线下跨域
解决跨域有多种方法:
	1、使用vue项目中的webpack配置proxy反向代理。
	2、使用nginx反向代理。
	3、使用jsonp。
	4、后台添加代码。
		A) header('Access-Control-Allow-Origin:*');//允许所有来源访问
		B) header('Access-Control-Allow-Method:POST,GET');//允许访问的方式
项目开发阶段一般是在webpack配置proxy反向代理。项目上线之后一般后端解决。
CORS:跨域资源共享(CORS)是一种机制;当一个资源访问到另外一个资源(这个资源放在不同的域名或者不同的协议或者端口),资源就会发起一个跨域的HTTP请求需要浏览器和服务器同时支持;
1. 整个CORS通信,都是浏览器自动完成。浏览器发现了AJAX请求跨源,就会自动添加一些附加的头信息,有时还会多出一次附加的请求,但用户不会有感觉;
2. 实现CORS的关键是服务器,只要服务器实现了CORS接口,就可以跨源通信
3. 服务器对于不同的请求,处理方式不一样; 有简单请求和非简单请求
12、jsonp 的原理
jsonp: 利用 标签没有跨域限制的漏洞,网页可以得到从其他来源动态产生的 JSON 数据。JSONP请求一
定需要对方的服务器做支持才可以。
JSONP优点是简单兼容性好,可用于解决主流浏览器的跨域数据访问的问题。缺点是仅支持get方法具
有局限性,不安全可能会遭受XSS攻击。
声明一个回调函数,其函数名(如show)当做参数值,要传递给跨域请求数据的服务器,函数形参为要获
取目标数据(服务器返回的data)。
创建一个 <script> 标签,把那个跨域的API数据接口地址,赋值给script的src,还要在这个地址中向服
务器传递该函数名(可以通过问号传参:?callback=show)。
服务器接收到请求后,需要进行特殊的处理:把传递进来的函数名和它需要给你的数据拼接成一个字符
串,例如:传递进去的函数名是show,它准备好的数据是 show('我不爱你') 。
最后服务器把准备的数据通过HTTP协议返回给客户端,客户端再调用执行之前声明的回调函数
(show),对返回的数据进行操作。
利用script标签的src的跨域属性

1)创建script标签
		var script = document.createElement('script');
2)设置回调函数
	function getData(data){
		//数据请求回来会被触发的函数
		console.log(data);
	}
3)设置script标签的src属性,设置请求的地址
		script.src = 'http://localhost:3000?callback=getData'
4)让script生效
		document.body.appendChild(script)
5)后台设置代码
	(比如后端用的是node搭建的服务器)
  ...获取到callback的值
  	然后调用callback的值(前端函数)并传递数据
  	var data = {
        name:"jxk",
        age:20
  	}
  	var scriptStr = `${query.callback}(${JSON.stringify(data)})`
  	res.end(scriptStr)
⭐ 3、cookie 、localstorage 、 sessionstrorage 之间有什么区别?
本地存储有localStorage、sessionStorage和cookie,但他们之间是有区别的。

	它们都是用来保存信息的。cookie兼容所有的浏览器,低版本的浏览器不支持localStorage和sessionStorage(IE6,7,8)
    cookie需要程序员自己封装函数实现,localStorage、sessionStorage提供了友好的API生成及存储位置
	cookie服务器端生成,通过浏览器存储在客户端,每次发送请求的时候会携带cookie
	localStorage、sessionStorage,客户端生成,存储在客户端(浏览器端)和服务器没有关系

大小区别:
	localStorage、sessionStorage一个源下最多只能存储5MB左右,(可以存储5m)
	cookie有存储的大小限制,一般一个源(一个域下)只能存储4KB内容(cookie只能存储4kb)。

有效期的区别:
	localStorage 可以长期存储数据,浏览器关闭后数据不丢失,除非手动删除。
	sessionStorage 数据在当前浏览器窗口关闭后自动删除
	Cookie 设置的cookie过期时间之前一直有效,与浏览器是否关闭无关

安全问题:
	cookie会把消息上传到服务器端最不安全。
	localstorage和sessionstorage都会留在本地所以更安全。

与服务器交互:
cookie 是网站为了标示用户身份而储存在用户本地终端上的数据(通常经过加密)
cookie 始终会在同源 http 请求头中携带(即使不需要),在浏览器和服务器间来回传递
sessionStorage 和 localStorage 不会自动把数据发给服务器,仅在本地保存

localStorage与sessionStorage的区别:
    localStorage只要在相同的协议、相同的主机名、相同的端口下,即同源就能读取/修改到同一份localStorage数据。
    sessionStorage比localStorage更严苛一点,除了协议、主机名、端口外,还要求在同一窗口(也就是浏览器的标签页)下。

    存入到 localStorage 和 sessionStorage 的都是字符串,因此如果是要将一个对象存入 localStorage/sessionStorage 的话,是需要先用 JSON.stringify() 序列化对象的,读取时也需要 JSON.parse() 转换为真正的 JS 对象。
⭐ 4、get 和 post 请求有哪些区别?
1、get和post在HTTP中都代表着请求数据,其中get请求相对来说更简单、快速,效率高些
2、get相对post安全性低
3、get有缓存,post没有
4、get体积小,post可以无限大
5、get的url参数可见,post不可见
6、get只接受ASCII字符的参数数据类型,post没有限制
7、get请求参数会保留历史记录,post中参数不会保留
8、get会被浏览器主动catch,post不会,需要手动设置
9、get在浏览器回退时无害,post会再次提交请求


get:一般用于信息获取,使用url传递参数,对所发送信息的数量也有限制,一般在2000个字符,有的浏览器是8000个字符
post:一般用于修改服务器上的资源,对所发送的信息没有限制(post通过请求体将数据传向后台)
	在以下情况中,使用post请求
	1.无法使用缓存文件(更新服务器上的文件或数据库)
	2.向服务器发送大量数据(post没有数据限制)
	3.发送包含未知字符的用户输入时,post比get更稳定也更可靠
GET:一般用于信息获取,使用 URL 传递参数,对所发送信息的数量也有限制,一般在 2000 个字符
POST:一般用于修改服务器上的资源,对所发送的信息没有限制。
GET 方式需要使用 Request.QueryString 来取得变量的值,而 POST 方式通过 Request.Form 来获取变量
的值,也就是说 Get 是通过地址栏来传值,而 Post 是通过提交表单来传值。
然而,在以下情况中,请使用 POST 请求:
无法使用缓存文件(更新服务器上的文件或数据库)
向服务器发送大量数据(POST 没有数据量限制)
发送包含未知字符的用户输入时,POST 比 GET 更稳定也更可靠
⭐ 5、原生 Ajax 请求的五个步骤
1.创建一个XMLHttpRequest异步对象
2.设置请求方式和请求地址
3.用send发送请求
4.监听状态变化
5.接收返回的数据并处理数据

通过XMLHttpRequest对象,向服务器发送请求,返回数据由javascript+css进行处理,从而渲染DOM
6、CSRF 和 XSS 的区别
CSRF ( Cross-site request forgery ):跨站请求伪造。
方法一、Token 验证:(用的最多)
1 . 服务器发送给客户端一个 token ;
2 . 客户端提交的表单中带着这个 token 。
3 . 如果这个 token 不合法,那么服务器拒绝这个请求。
方法二:隐藏令牌:
把 token 隐藏在 http 的 head 头中。
方法二和方法一有点像,本质上没有太大区别,只是使用方式上有区别。
方法三、Referer 验证:
Referer 指的是页面请求来源。意思是,只接受本站的请求,服务器才做响应;如果不是,就拦截


XSS(Cross Site Scripting):跨域脚本攻击。
1. 编码:
   对用户输入的数据进行 HTML Entity 编码。
   如上图所示,把字符转换成 转义字符。
   Encode 的作用是将 $var`等一些字符进行转化,使得浏览器在最终输出结果上是一样的。
   比如说这段代码:
   若不进行任何处理,则浏览器会执行alert的js操作,实现XSS注入。进行编码处理之后,L在浏览
   器中的显示结果就是 <script>alert(1)</script> ,实现了将 `$var 作为纯文本进行输出,且
   不引起J avaScript 的执行。
2、过滤:
   移除用户输入的和事件相关的属性。如 onerror 可以自动触发攻击,还有 onclick 等。(总而言
   是,过滤掉一些不安全的内容)
   移除用户输入的 Style 节点、 Script 节点、 Iframe 节点。(尤其是 Script 节点,它可是支持
   跨域的呀,一定要移除)。
3、校正
   避免直接对 HTML Entity 进行解码。
   使用 DOM Parse 转换,校正不配对的 DOM 标签。
   备注:我们应该去了解一下 DOM Parse 这个概念,它的作用是把文本解析成 DOM 结构。
   比较常用的做法是,通过第一步的编码转成文本,然后第三步转成 DOM 对象,然后经过第二步的过滤。

区别一:
CSRF :需要用户先登录网站 A ,获取 cookie
XSS :不需要登录。
区别二:(原理的区别)
CSRF :是利用网站 A 本身的漏洞,去请求网站 A 的 api 。
XSS :是向网站 A 注入 JS 代码,然后执行 JS 里的代码,篡改网站 A 的内容。
7、网络请求的方式
1、原生ajax
2、jq中的ajax
3、es6中的fetch
4、vue项目及react项目中使用axios.js
5、jsonp
6、vue1.0中使用vue-resource.js
8、tcp 、udp 协议(是什么?用途?)
⭐ 9、一个页面从输入 URL 到页面加载显示完成,这个过程中都发生了什么?
01.浏览器查找域名对应的IP地址(DNS 查询:浏览器缓存->系统缓存->路由器缓存->ISP DNS 缓存->根域名服务器)
02.浏览器向 Web 服务器发送一个 HTTP 请求(TCP三次握手)
03.服务器 301 重定向(从 http://example.com 重定向到 http://www.example.com)
04.浏览器跟踪重定向地址,请求另一个带 www 的网址
05.服务器处理请求(通过路由读取资源)
06.服务器返回一个 HTTP 响应(报头中把 Content-type 设置为 'text/html')
07.浏览器进 DOM 树构建
08.浏览器发送请求获取嵌在 HTML 中的资源(如图片、音频、视频、CSS、JS等)
09.浏览器显示完成页面
10.浏览器发送异步请求
⭐ 10、cookie 和 session 的区别
1、cookie 数据存放在客户的浏览器上,session 数据放在服务器上。
2、cookie 不是很安全,别人可以分析存放在本地的 COOKIE 并进行 COOKIE 欺骗,考虑到安全应当使用 session。
3、session 会在一定时间内保存在服务器上。当访问增多,会比较占用你服务器的性能,考虑到减轻服务器性能方面,应当使用 COOKIE。
4、单个 cookie 保存的数据不能超过 4K,很多浏览器都限制一个站点最多保存 20 个 cookie。
5、所以个人建议:
    将登陆信息等重要信息存放为 SESSION
    其他信息如果需要保留,可以放在 COOKIE 中
⭐ 11、token 是什么?(加密)
1. token 也可以称做令牌,一般由 uid+time+sign(签名)+[固定参数] 组成
   uid: 用户唯一身份标识
   time: 当前时间的时间戳
   sign: 签名, 使用 hash/encrypt 压缩成定长的十六进制字符串,以防止第三方恶意拼接
   固定参数(可选): 将一些常用的固定参数加入到 token 中是为了避免重复查库
2. token 在客户端一般存放于 localStorage,cookie,或 sessionStorage 中。在服务器一般存于数据库中
3. token 的认证流程
   用户登录,成功后服务器返回 Token 给客户端。
   客户端收到数据后保存在客户端
   客户端再次访问服务器,将 token 放入 headers 中 或者每次的请求 参数中
   服务器端采用 filter 过滤器校验。校验成功则返回请求数据,校验失败则返回错误码
4. token 可以抵抗 csrf,cookie+session 不行
5. session 时有状态的,一般存于服务器内存或硬盘中,当服务器采用分布式或集群时,session 就会面对负载均衡问题。负载均衡多服务器的情况,不好确认当前用户是否登录,因为多服务器不共享session
6. 客户端登陆传递信息给服务端,服务端收到后把用户信息加密(token)传给客户端,客户端将token 存放于 localStroage 等容器中。客户端每次访问都传递 token,服务端解密 token,就知道这个用户是谁了。通过 cpu 加解密,服务端就不需要存储 session 占用存储空间,就很好的解决负载均衡多服务器的问题了。这个方法叫做 JWT(Json Web Token)
⭐ ✔️ 47、什么是 token(说说你对 token 的理解)
用于做用户的唯一身份的识别。
1、Token的引入:Token是在客户端频繁向服务端请求数据,服务端频繁的去数据库查询用户名和密码并进行对比,判断用户名和密码正确与否,并作出相应提示,在这样的背景下,Token便应运而生。

2、Token的定义:Token是服务端生成的一串字符串,以作客户端进行请求的一个令牌,当第一次登录后,服务器生成一个Token便将此Token返回给客户端,以后客户端只需带上这个Token前来请求数据即可,无需再次带上用户名和密码。

3、使用Token的目的:Token的目的是为了减轻服务器的压力,减少频繁的查询数据库,使服务器更加健壮。

https://blog.csdn.net/qq_38129062/article/details/89350244
13、http 请求
指从客户端到服务器端的请求消息
⭐ 14、http 请求方式有那些?
HTTP请求的方法:
	HTTP1.0定义了三种请求方法: GET, POST 和 HEAD方法。
	HTTP1.1新增了五种请求方法:OPTIONS, PUT, DELETE, TRACE 和 CONNECT 方法
⭐ 16、http 请求的状态码
http的状态码有很多
http状态码分为五类:
	1开头的代表信息状态码
	2开头的代表成功状态码
	3开头的代表重定向状态码
	4开头的代表客户端错误状态码
	5开头代表服务端错误状态码
常用状态码有:
	200:请求成功
	301:被请求的资源已经永久移动到新位置
	304:所请求的资源未修改(缓存)。
	404:服务器无法根据客户端的请求找到资源
	500:服务器内部错误,无法完成请求
	503:由于超载或系统维护,服务器暂时无法处理客户端请求
301与303的区别:
	301转向(或叫301重定向,301跳转)是当用户或搜索引擎向网站服务器发出浏览请求时,服务器返回的HTTP数据流中头信息(header)中的状态码的一种,表示本网页永久性转移到另一个地址。
	303状态码:对于POST请求,它表示请求已经被处理,客户端可以接着使用GET方法去请求Location里的URI。
✔️ 44、restful API
Rest是web服务的一种架构风格,一种设计风格,是一种思想;同时Rest不是针对某一种编程语言的。
restful:遵守了rest风格的web服务,也就是webAPI接口规范,是后台人员编写。


非Rest设计,以往我们都会这么写:

	http://localhost:8080/admin/getUser (查询用户)
	http://localhost:8080/admin/addUser (新增用户)
	http://localhost:8080/admin/updateUser (更新用户)
	http://localhost:8080/admin/deleteUser (删除用户)

Rest架构:

GET 	http://localhost:8080/admin/user (查询用户)
POST 	http://localhost:8080/admin/user (新增用户)
PUT 	http://localhost:8080/admin/user (更新用户)
DELETE 	http://localhost:8080/admin/user (删除用户)

为什么需要Restful
	URL具有很强可读性的,具有自描述性
	规范化请求过程和返回结果
	资源描述与视图的松耦合
	可提供OpenAPI,便于第三方系统集成,提高互操作性
	提供无状态的服务接口,降低复杂度,可提高应用的水平扩展性

method请求方式
	get
	post
	put
	delete
	PATCH(一般不用)